封面为 AI 生成概念插画。正文中的算例图和白板图采用确定性绘图;数值来自独立教学脚本,未冒充 RadishFlow 的实机计算结果。
前一篇拆开了 RadishFlow 的软件架构,留下一个问题:如果单元模型已经会计算入口到出口,为什么还需要讨论序贯模块、联立模块和联立方程?给现有求解器换一种迭代算法,是否就够了?
我觉得要回答它,最好不要从术语开始。我们在白板上画一个带回流的反应流程,只用几个变量,亲手走一轮计算,再看看三种写法分别把什么交给了全局求解器。
先交代实现边界:截至 2026 年 9 月 29 日,RadishFlow 已有无回路的序贯模块执行链,尚未实现本文的回流收敛、反应器、联立模块、EO 或混合装配。下面的模型是为讲解另建的算例,配有可独立运行的 Python 实现。它帮助我们推敲未来接口,并不代表产品已经具备这些功能。
一、不要换流程:三种方法都算这一张图
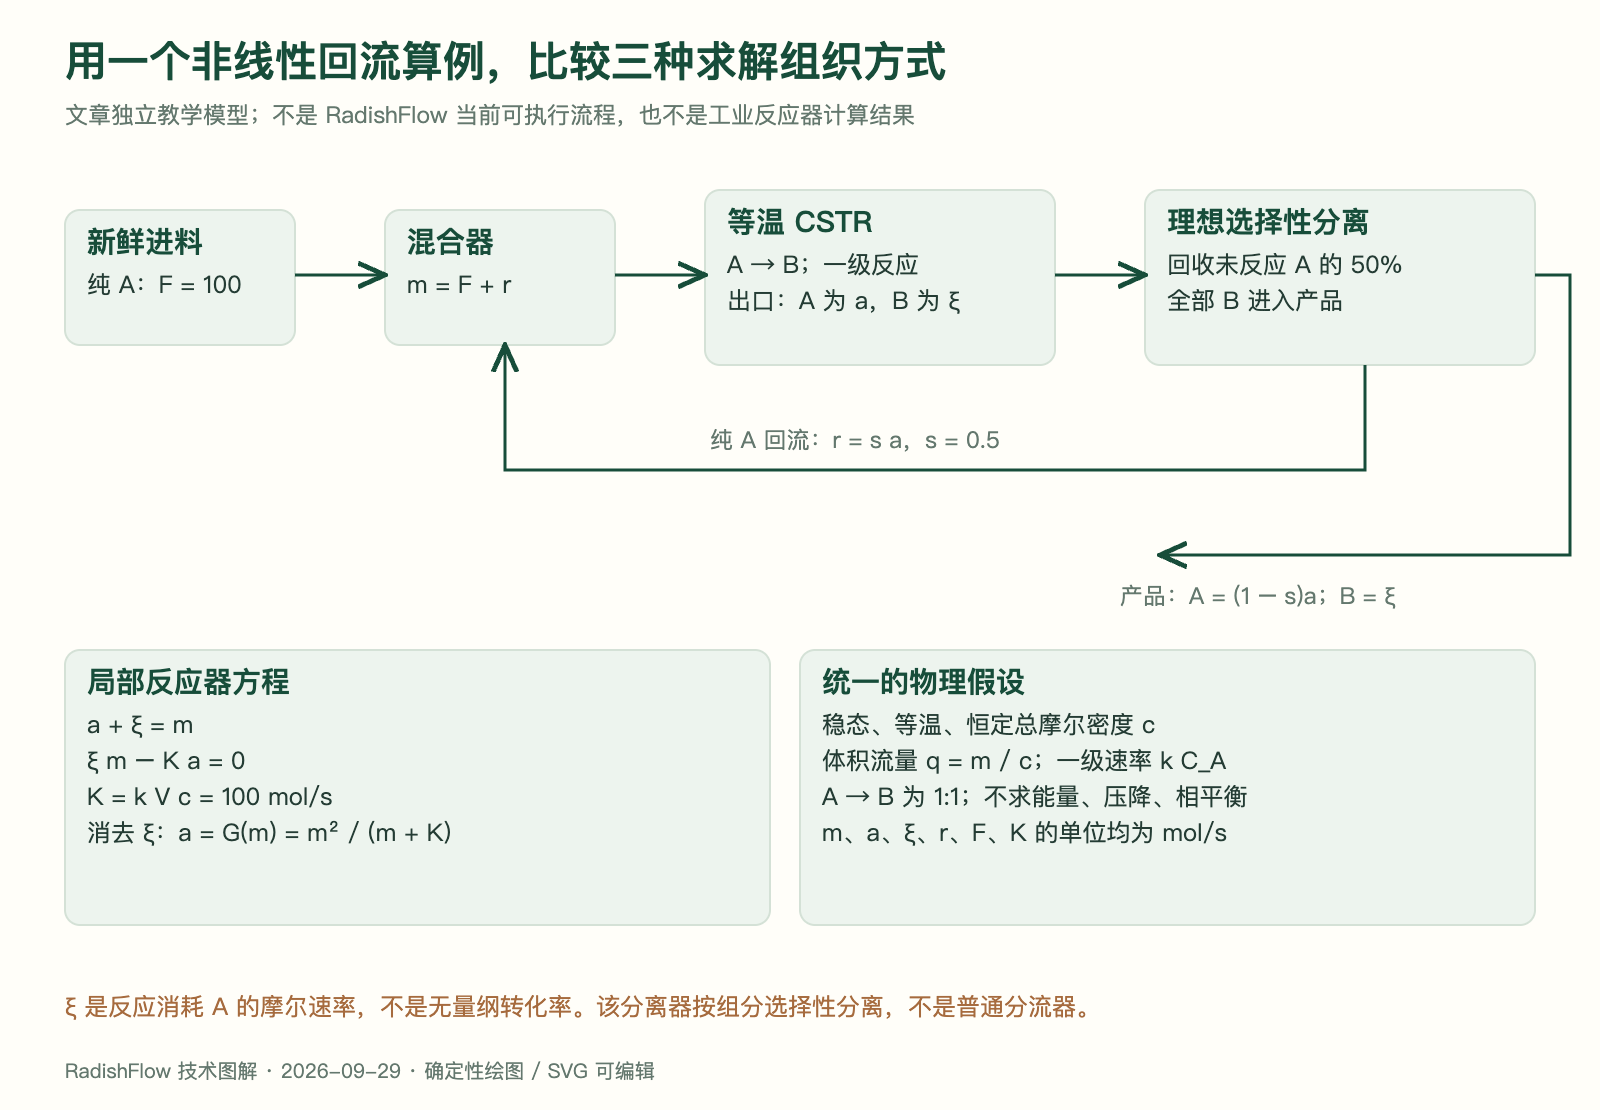
图 1|同一套物理假设、同一个回流流程。这里是按组分选择性分离的理想分离器,不是把整股物流等比例切开的普通分流器。
新鲜进料是纯 A,流量 F = 100 mol/s。它与回流混合,进入一台稳态、等温、充分混合的液相反应器,发生一级反应 A → B,化学计量比为 1:1。分离器把未反应 A 的一半送回入口,把剩余 A 和全部 B 作为产品送出。
为了只观察求解结构,我暂时不引入温度、压降和相平衡计算。总摩尔密度 c 视为常数,反应器体积 V 和速率常数 k 固定;等温条件视为由外界维持,不计算其热负荷。A 与 B 的体积变化也按这个恒密度近似处理。这些都是教学模型的假设,不能原样搬到任意真实反应体系。
宽表格可左右滑动
| 符号 | 意义 | 本算例的角色 |
|---|---|---|
| F | 新鲜 A 进料 | 已知,100 mol/s |
| r | 纯 A 回流 | 待求,mol/s |
| m | 反应器入口总流量,也是出口总流量 | 待求,mol/s |
| a | 反应器出口未反应 A 的流量 | 待求,mol/s |
| ξ | 反应消耗 A、生成 B 的摩尔速率 | 待求,mol/s |
| K | kVc,合并后的反应能力参数 | 已知,100 mol/s |
| s | 未反应 A 的回收比例 | 已知,0.5 |
注意 ξ 有流量单位,不是无量纲转化率。单程转化率应该是 ξ/m。
充分混合意味着反应器内部浓度等于出口浓度。体积流量 q = m/c,所以 A 的浓度是 a/q,反应消耗速率是 ξ = kV(a/q)。整理以后,得到下面两条局部关系:
a + ξ = m                    组分 A 的稳态衡算
ξ m − K a = 0                一级反应动力学,K = kVc
CSTR 中用反应速率与反应体积关联反应进度,是常见的建模方式;IDAES 2.9.0 的 CSTR 文档也给出了这种关系。这里进一步作了自己的等温、恒密度与单反应简化,没有使用其软件结果。
把 ξ = m − a 代入第二条关系,就能消掉反应器内部的反应量,得到入口到出口的响应函数:
(m − a)m = K a

                 m²
a = G(m) = ─────────────
               m + K

ξ = m − a
它是非线性的。入口变大时,固定体积下停留时间会缩短,单程转化率随之变化;不能把反应器简单替换成一个固定转化率比例。整个流程还必须同时满足 m = F + r 与 r = s a。三种策略要满足的物理关系完全相同,区别在于怎样组织它们。
二、序贯模块:先猜回流,再沿流程算一遍
我先把回流线“撕开”。撕裂的意思是:临时把回流入口当成给定值,沿着混合器、反应器和分离器依次计算,最后检查算出来的回流是否等于一开始的猜测。
下面是直接代入迭代的弱代码。reactor 在内部满足前面两条局部关系,外层只反复更新 r。
def reactor(m, K):
    a = m * m / (m + K)
    return a, m - a

r = 0.0
for iteration in range(max_iterations):
    m = F + r
    a, xi = reactor(m, K)
    r_calculated = s * a
    residual = r_calculated - r

    if abs(residual) / F < tolerance:
        return m, a, xi, r

    r = r_calculated

raise ConvergenceError("回流未闭合")
第一次假设完全没有回流:r = 0,因此 m = 100。反应器给出 a = 50、ξ = 50,分离器算出回流 25。但我们一开始猜的是零,这次计算的回流残差就是 25 mol/s。
把 25 送回入口再算,反应器进料变为 125,未反应 A 变为 69.444444,于是新的回流是 34.722222。前几轮如下;表中都是 mol/s,按显示位数取舍,实际计算不逐轮舍入。
宽表格可左右滑动
| 轮次 | 猜测 r | 入口 m | 算得 A 出口 a | 新回流 s·a | 回流残差 |
|---|---|---|---|---|---|
| 0 | 0.000000 | 100.000000 | 50.000000 | 25.000000 | 25.000000 |
| 1 | 25.000000 | 125.000000 | 69.444444 | 34.722222 | 9.722222 |
| 2 | 34.722222 | 134.722222 | 77.325773 | 38.662886 | 3.940664 |
| 3 | 38.662886 | 138.662886 | 80.562991 | 40.281496 | 1.618609 |
| 4 | 40.281496 | 140.281496 | 81.899349 | 40.949674 | 0.668179 |
每一轮中,反应器的局部方程已经满足;整个流程暂时没有满足的是“猜测回流=计算回流”。这就是这一写法的收敛边界。
直接代入为什么在这里可用?令 H(r) = sG(F+r),迭代就是 r_next = H(r)。求导得到:
G′(m) = 1 − [K / (m + K)]²
H′(r) = s G′(F + r)
在本算例的解附近,H′ ≈ 0.4142,绝对值小于 1,因此有局部收缩条件。这个判断只服务于当前简化模型;复杂回流中的热耦合、相变和更强反馈可能改变收敛性。
SM 也不必永远使用直接代入。可以对撕裂变量使用阻尼、加速,甚至对 H(r) − r = 0 做 Newton 迭代。是否用了 Newton,不能单独决定一个流程模拟方法是不是 EO。只要设备内部仍由局部模型计算,外层只是让回流闭合,它的模型组织边界就没有因此变成全局方程导出。
三、联立模块:一起匹配各模块的边界变量
现在保留同一个反应器函数 G(m),但换一种全局组织方式。我不再只猜回流,而是把入口流量、反应器 A 出口流量和回流都交给全局:
z = (m, a, r)

R₁(z) = m − F − r
R₂(z) = a − G(m)
R₃(z) = r − s a

要求 R(z) = 0
这是一种便于讲解的联立模块组装方式:局部模型负责输入到输出的响应,全局求解器让所有边界一致。实际算法可以选择不同的边界变量、进一步消元或使用近似响应,不一定照抄这三个未知量。这里用它观察“局部模型保留了什么”。
Newton 步需要响应导数,当前解析函数可以直接求导。其 Jacobian,也就是残差对未知量的偏导矩阵,为:
              m          a       r
       ┌                              ┐
J =    │      1          0      −1    │
       │   −G′(m)        1       0    │
       │      0         −s       1    │
       └                              ┘

J(z) Δz = −R(z)
z_next = z + α Δz
从 z₀ = (100, 50, 0) 出发,前两个残差是零,第三个是 −25。此时 G′(100) = 0.75。解这组线性方程,得到 Δz = (40, 30, 40);本例第一步可以接受完整步长 α = 1,于是 z₁ = (140, 80, 40)。
看起来回流和混合器都闭合了:140 − 100 − 40 = 0,40 − 0.5 × 80 = 0。但把 140 重新送进真实的局部反应器函数,得到的是 G(140) = 81.666667。全局猜测的 a 只有 80,所以第二个残差仍是 −1.666667,还得继续迭代。
这一轮很好地暴露了边界:局部反应器能够给出自洽响应,不代表全局猜测的出口已经与那个响应一致。联立模块在做的,就是把这些差距同时压到容差以内。
复杂单元可能没有显式的 G(m) 公式,但可以通过内部迭代给出输出,也可以通过解析灵敏度、自动微分或有限差分提供响应导数。若使用有限差分,扰动一次入口就可能触发一次局部求解;局部容差和失败行为会影响全局导数质量。因此,“能够运行一次”与“适合被联立模块求解器反复调用”,仍然是不同的能力要求。
早期联立模块文献中已有利用模块响应组织整体计算的思路。这里的例子用于解释这种边界,不声称完整复现某一篇算法,也不把“联立模块”解释成“同时开多个线程”。
四、联立方程 EO:把反应器内部关系也交出来
第三种写法中,我不再要求全局只能通过 a = G(m) 认识反应器,而是让反应量 ξ 也成为全局未知量,把原始的局部关系直接并入方程组:
u = (m, a, ξ, r)

E₁(u) = m − F − r
E₂(u) = a + ξ − m
E₃(u) = ξ m − K a
E₄(u) = r − s a

要求 E(u) = 0
第三条是非线性方程;其他三条在本例中是线性的。反应器内部的衡算与动力学,不再只是一个被隐藏在函数内的局部计算结果,而是全局残差的一部分。
对应的 Jacobian 为:
             m       a       ξ       r
       ┌                                  ┐
J_E =  │     1       0       0      −1    │
       │    −1       1       1       0    │
       │     ξ      −K       m       0    │
       │     0      −s       0       1    │
       └                                  ┘
从 u₀ = (100, 50, 50, 0) 出发,只有回流残差是 −25。第一步解得 Δu = (40, 30, 10, 40),更新到 u₁ = (140, 80, 60, 40)。
这次混合器、物料衡算与分离关系都满足了,但动力学残差是 60 × 140 − 100 × 80 = 400。也就是说,EO 的中间候选点可以暂时不满足反应器的内部关系,最后由全局迭代一起收敛。
这不能被解释为“EO 不需要物理模型”,也不是允许把不满足物理关系的试探点作为最终结果。局部消元式写法要求每次局部调用先做到自洽;EO 把这种一致性要求移到了全局残差体系里。复杂模型中仍需要合理的初始化、变量边界和求值域管理,避免试探到负压力、非法组成或物性无定义区域。
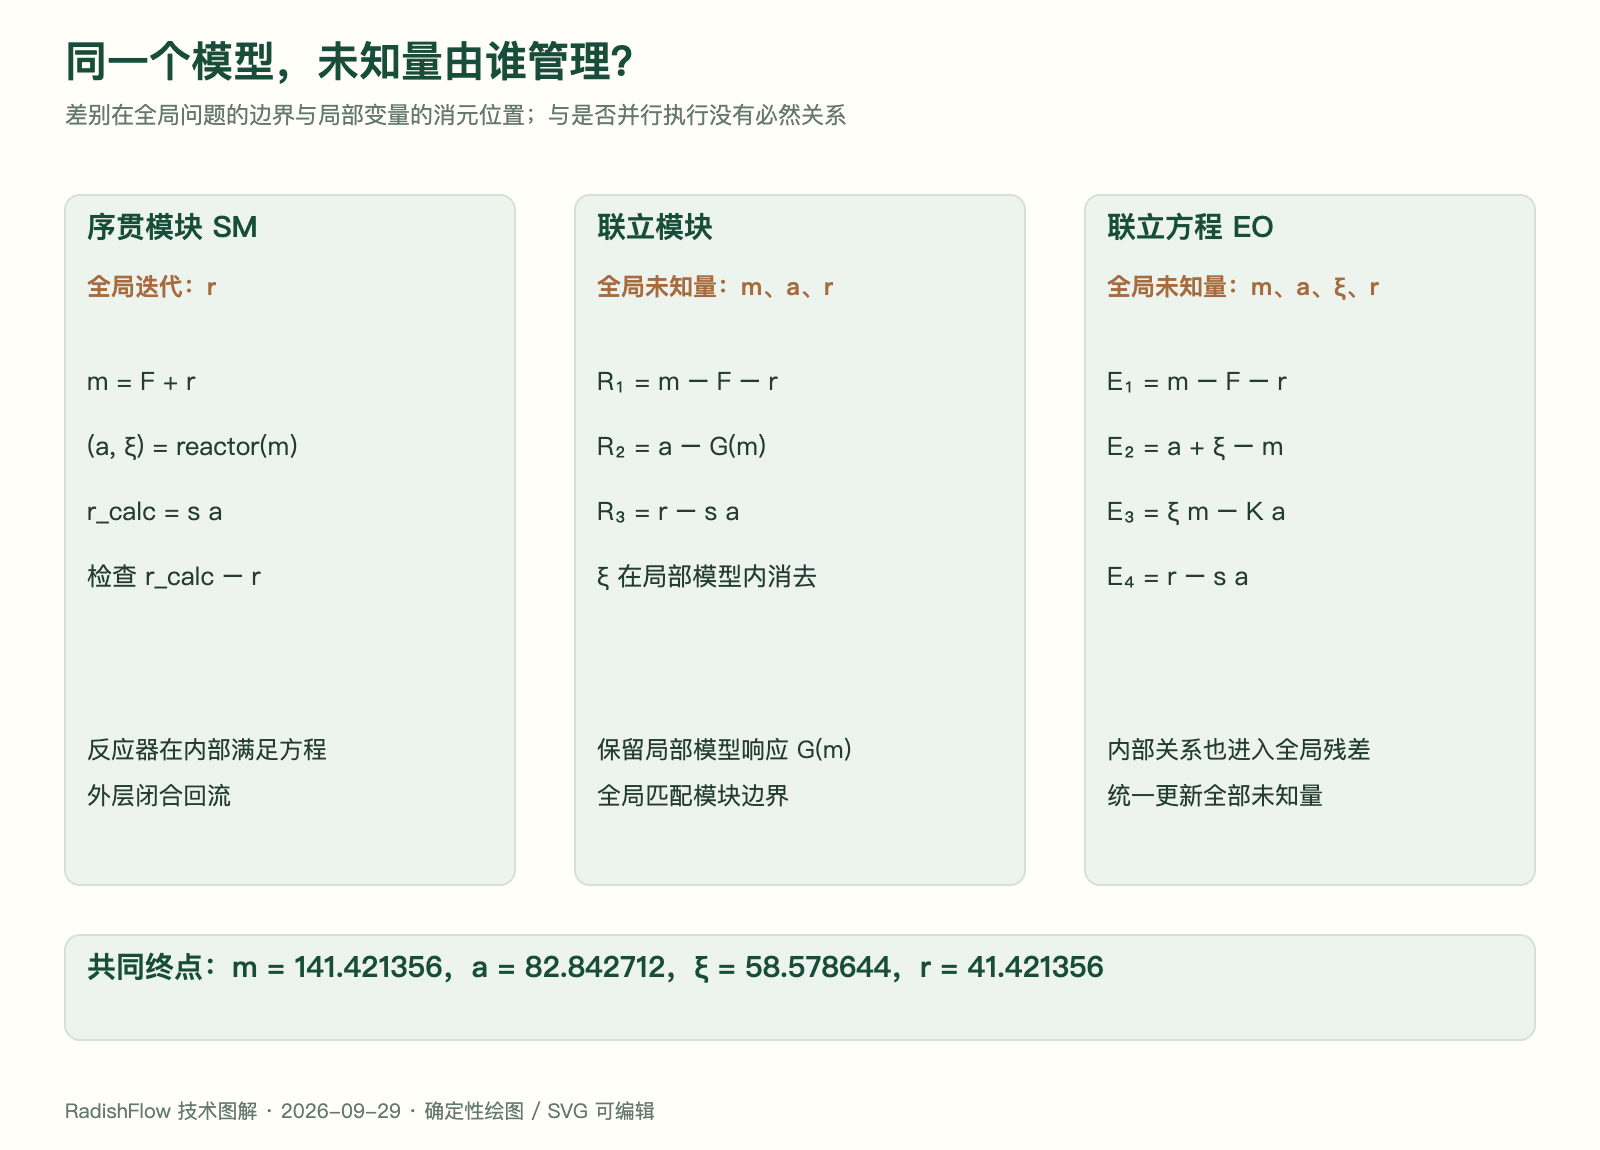
图 2|同一个模型的三种组装。联立模块栏是本文选用的边界变量形式,不是所有联立模块算法唯一的变量清单。
五、最值得看的联系:局部消元把什么藏起来了
如果把前两节只读成“三个变量和四个变量的区别”,技术含义仍然不够。真正关键的是:联立模块用到的 G′(m),从哪里来?
它可以从 EO 中那两条反应器关系推出来。对它们作微分,保持参数 K 不变:
a + ξ = m         →  da + dξ = dm
ξ m − K a = 0     →  ξ dm + m dξ − K da = 0

代入 dξ = dm − da:
(m + ξ) dm − (m + K) da = 0

因此:
da/dm = (m + ξ) / (m + K)
      = m(m + 2K) / (m + K)²
      = G′(m)
所以局部响应函数不是凭空多出来的第二套物理模型。它把内部未知量解掉了,并把内部关系对边界的影响压缩到了输出和响应导数中。在线性化系统里,这与消去内部变量、形成缩减系统的思想相通。
这也解释了为什么模块的灵敏度如此重要。局部求解返回一个出口值,告诉全局“在这个入口下,出口是多少”;响应导数进一步告诉它“入口变化一点,出口怎样变化”。后者把被消去的内部结构,以压缩形式带回了全局问题。
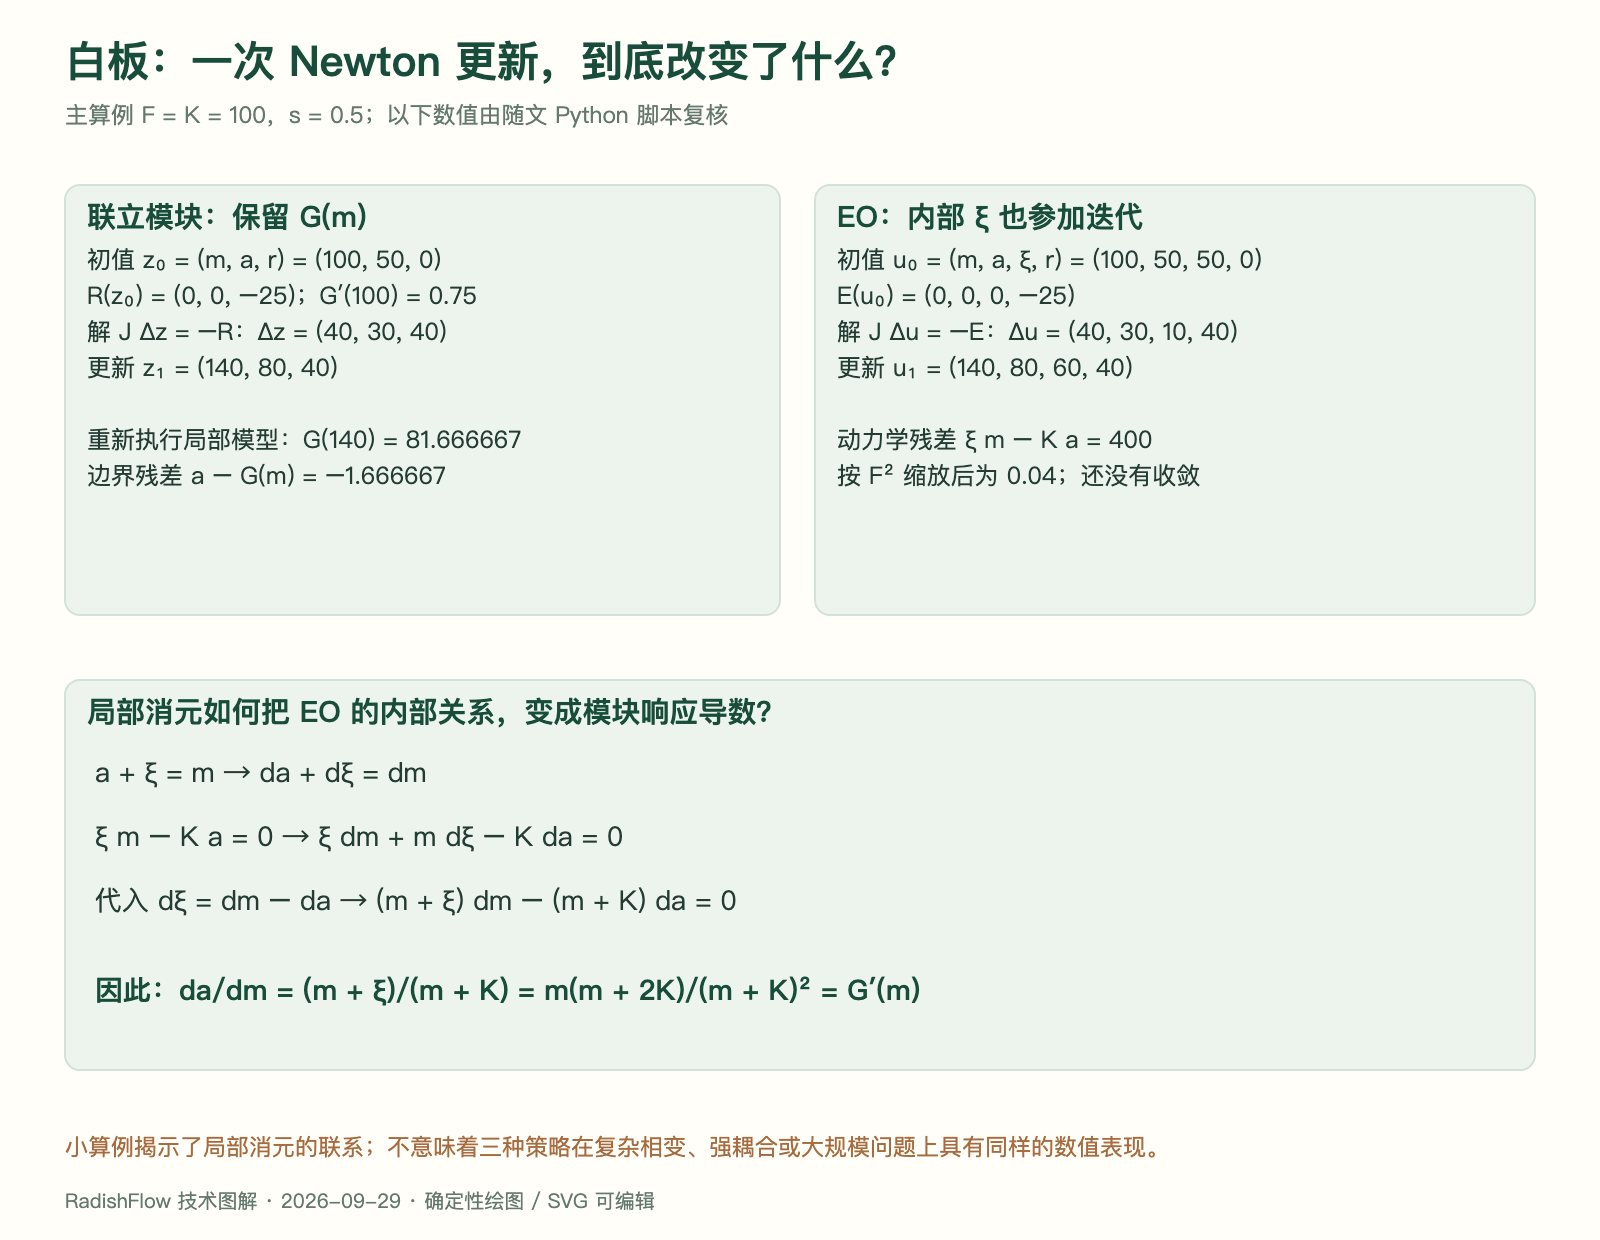
图 3|白板推导。两种 Newton 写法使用各自的残差与解析 Jacobian。第一步后的非零残差有不同量纲,不能直接拿 1.666667 与 400 比大小。
当然,局部消元不是免费午餐。如果局部问题多解、接近奇异或跨越相态边界,响应可能不平滑,导数也可能变得难以可靠获得。反过来,把更多内部变量交给全局,也会扩大问题规模,增加初始化和线性代数方面的要求。
因此我不会根据这个四变量例子下结论,说哪一类方法普遍更快。它没有复杂闪蒸、没有热集成、没有大型稀疏系统,也没有代表性的性能测试。这个例子证明的是三种写法的组织关系和数值一致性。
六、收敛不是打印一个“成功”:先把尺度和闭合检查写清楚
本例里前三个流量类变量的数值大约是几十到一百。但 EO 的动力学方程 ξm − Ka 单位是 (mol/s)²,其他残差单位是 mol/s。直接用原始残差的最大值作为统一判据,就把不同量纲混在了一起。
教学脚本用 F 作为流量尺度,用 F² 作为动力学残差尺度,再检查缩放后的无穷范数。对主算例,两种 Newton 组装和 SM 都以相应的无量纲残差小于 10⁻¹² 为停止条件;这只是为了让短算例便于复核,不是建议所有工程模型都使用这个容差。
EO equation scales = (F, F, F², F)
scaled_residual[i] = E[i] / equation_scales[i]

while max(abs(scaled_residual)) >= tolerance:
    solve scaled_J * delta = -scaled_residual
    try alpha = 1
    reduce alpha until trial is in domain
        and scaled residual norm decreases
    accept trial, then evaluate again
随文完整脚本还限制试探点的流量非负、入口流量大于零,并做回溯步长检查。它使用小型稠密线性方程求解,足够验证四五个变量的教学模型;这不是工业求解器后端。更大模型还需要变量尺度、稀疏结构、秩与条件数等方面的处理。
我们还能绕过所有迭代,得到一个独立的解析检查。由 r = sa、m = F+r、a = m²/(m+K) 可得:
(1 − s)m² + (K − F)m − FK = 0

代入 F = K = 100,s = 0.5:
0.5 m² − 10000 = 0

取满足 m > 0 的根:m = √20000
另一根是负数,不属于该模型的有效域。三种数值写法都得到下面这个物理解:
宽表格可左右滑动
| 结果 | 数值(mol/s) |
|---|---|
| 反应器总进料 m | 141.421356 |
| 反应器 A 出口 a | 82.842712 |
| 生成 B 的速率 ξ | 58.578644 |
| 回流 r | 41.421356 |
| 产品中的 A | 41.421356 |
| 产品中的 B | 58.578644 |
验证时不能只看三种方法彼此相等,因为它们可能共享同一个错误。脚本还对照上述二次方程的正根,检查全套原始方程残差、回流闭合,以及产品 A 与 B 总流量等于新鲜进料 100 mol/s。解析导数也与中心差分作了交叉检查。
除主算例外,又检查了 K 取 50、100、200,s 取 0、0.5、0.9 的九个组合。它们扩展了这个简化模型的数值检查范围,但没有变成对真实反应物性或大型求解性能的验证。完整实现与逐步结果保存在文章配套的 examples/recycle_demo.py 和 verification-results.json 中,运行脚本只需 Python 标准库。
七、把问题倒过来,为什么变量与规格必须分开
现在换一个工程提问:我不再固定 K,而是要求产品 B 达到 60 mol/s,反求需要的 K。
流图没变,物理关系也没变;改变的是规格。原来 K 是参数,ξ 是待求结果;现在把 K 放进未知量,再补一条 ξ − 60 = 0。未知量从四个变成五个,独立方程也从四条变成五条。
这个小例子可以直接算出:产品 A 必须是 40;s = 0.5 意味着反应器 A 出口为 80,回流为 40,入口 m 为 140。于是 K = ξm/a = 60 × 140 / 80 = 105 mol/s。配套脚本也用五变量 EO 写法核对了这个结果。
序贯模块同样可以处理这一需求,例如在外面再加一层调节 K 的设计规格迭代。不能把反算能力当作 EO 独占。区别在于,我们是把外层设计迭代套在完整流程计算外面,还是把新未知量和规格直接加入整体问题。
这里也有两个常见错误。若固定 K 仍为 100,又强行增加 ξ = 60,就对这个原问题多加了一条不兼容规格。若释放 K 却不补规格,就留下一个自由度。即使方程数与未知量数相等,也还要检查方程是否独立,以及规格是否物理可行。
例如要求产品 B 大于新鲜 A 进料,在本模型的 1:1 反应和非负产品 A 条件下就不可行;达到恰好 100 则需要在这个简化动力学模型中考虑无限反应能力的极限。继续加迭代次数不能把这样的有限设计解“算出来”。
八、回到 RadishFlow:多策略扩展到底需要增加什么
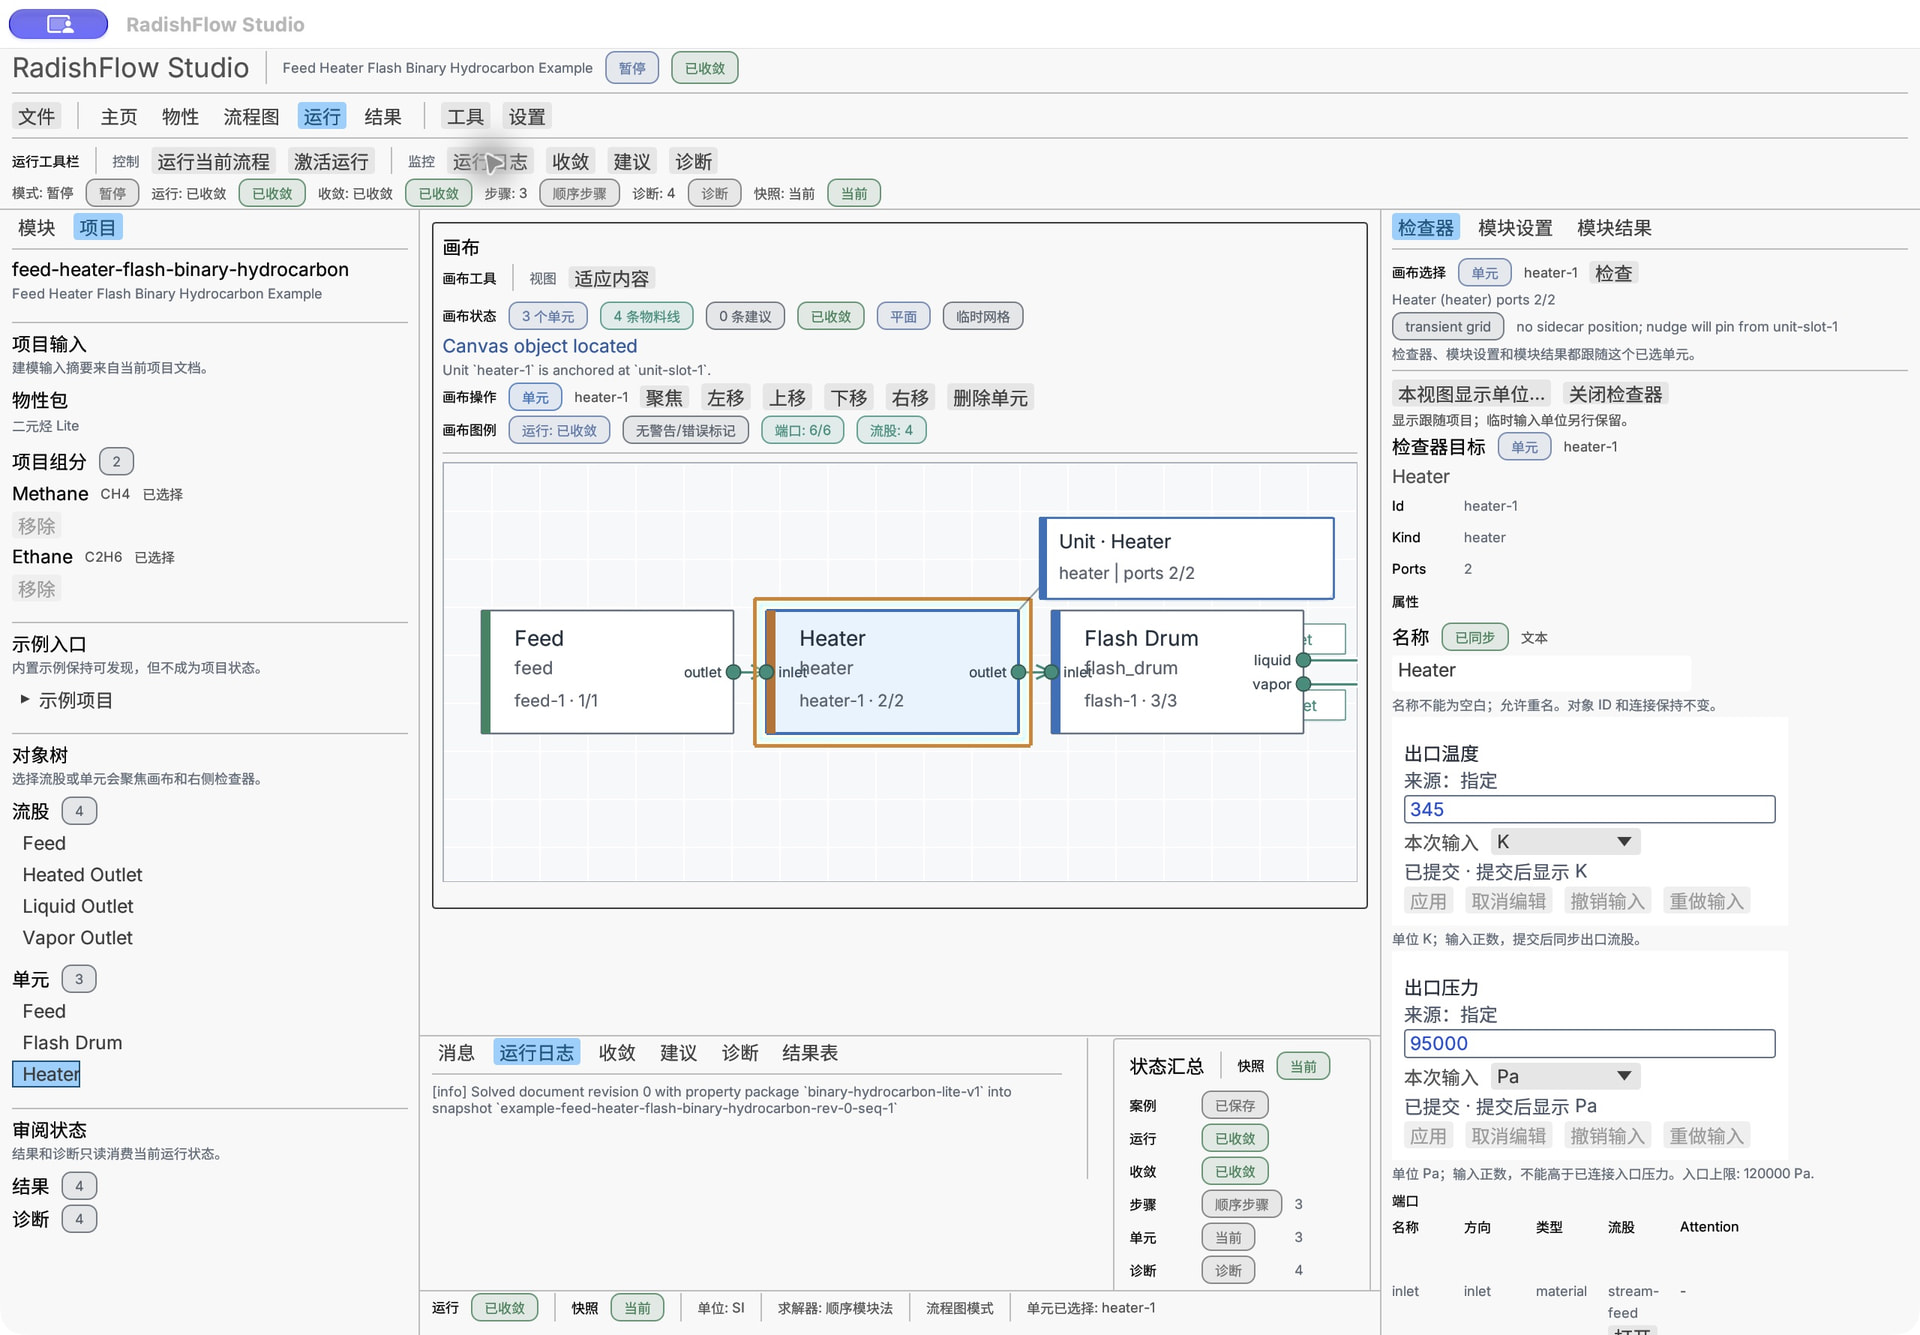
图 4|当前实机基线:9 月 29 日取景于本机已有的 9 月 28 日构建,Heater–Flash 无回路示例。没有在界面中切换到本文的三种策略,也没有运行本文反应回流算例。
当前 RadishFlow 单元主要通过 run(services, inputs) → outputs 提供局部计算,求解器做无环拓扑排序,逐个收集入口、调用单元、发布出口。这很适合作为当前 SM 主线的基础,但它没有表达变量清单、残差结构和 Jacobian 这些 EO 装配信息。
所以我更倾向于先描述模型具备什么能力,再决定问题怎样组装。下面仅是设计弱代码,不是已经落地的 Rust 接口:
ModelCapabilities:
    evaluate_local(inputs) -> outputs          # 局部响应
    boundary_derivatives(inputs) -> dY_dX      # 可选灵敏度
    declare_variables() -> variables           # 可选方程能力
    residual(values) -> residual_vector
    jacobian_pattern() -> sparsity
    initialize(context) -> starting_values
不是每一个模型都必须支持全部能力。保留成熟的黑箱局部单元,同时让一部分单元导出方程,会自然提出混合装配问题。此时需要明确哪些变量由局部消元,哪些进入全局,如何得到边界导数,局部失败怎样传递,以及迭代期间的临时状态怎样隔离。给黑箱套一个名字叫 residual 的函数,不能自动消除这些困难。
从本文算例看,一个装配器至少要能管理稳定的变量身份、固定值与未知量、方程到设备的来源、有效域、尺度,以及残差和导数访问方式。真正的数值后端再消费组装结果,进行线性代数与非线性迭代。这样,失败时才有机会从某行残差追到“反应器动力学关系”,而不是只看到一个没有工程语义的矩阵行号。
已有 UnitOperation::run 入口可以继续承载局部模型;为未来补充方程能力,不意味着要把所有设备都改写成同一种形式。它要求我们把可选能力、组装约束与运行生命周期讲清楚,也要求用具体算例验证它们真的能协作。
对我来说,这个小流程最有用的地方,是它让“支持多策略”变成了可检查的问题:SM 在闭合撕裂流,联立模块在匹配局部响应与边界,EO 在统一求解展开后的方程。模型假设相同的时候,它们应该回到同一个物理解;组织方式改变以后,初始化、导数、尺度和失败诊断的责任却会重新分配。下一步的软件设计,就应该沿着这些具体责任展开。