封面:概念示意,AI 生成。正文技术图为程序绘制,均非实机截图。
有人给我看过一张被介绍为用户与 DeepSeek“大肥鱼”对话的截图。用户说:“我只害怕有一天对话达到上限,你不记得我了。”回复中有一句:“所以我才天天写日记。”随后,它描述了重新翻阅日记、重新认识对方的情景。
这段话把一个技术问题说得很具体:当上下文消失,连续性由什么承载?截图不能证明后台真的写入日记,但“先保存经历,再按需找回”的思路,确实接近我在 RadishMemory 中希望建立的长期记忆机制。
我的判断是,实用的跨会话记忆已经有明确技术路径;难点在于区分保存、召回与正确使用。把资料存在磁盘、让模型学会某种规律、让下一次回答记起一件往事,分别对应不同的保证。
预测即压缩,但权重不是完整档案
Google DeepMind 等研究者的《Language Modeling Is Compression》研究了预测与压缩的联系。给定参数为 θ 的模型,文本序列的理想编码长度近似为:
这里的单位是比特;实际编码还存在额外开销。模型越能准确预测文本,就越能帮助编码器用较短的码表示它。1
但论文中的无损压缩需要概率模型、压缩比特流和一致的解码规则。其离线实验可以固定参数,让模型提供概率,再由算术编码生成比特流。只拿到模型权重,并不能据此逐字恢复输入。若收发双方没有共享模型,核算总成本还需要计入模型本身。1
预训练当然可以理解为从海量文本中提炼规律,也会记忆部分具体内容。不过,“知识压缩进参数”是对学习过程的概括,不是逐条原文无损保存的契约。模型擅长预测“生日快乐”,不代表它能仅凭这种规律确定谁在何时向谁说过这句话。
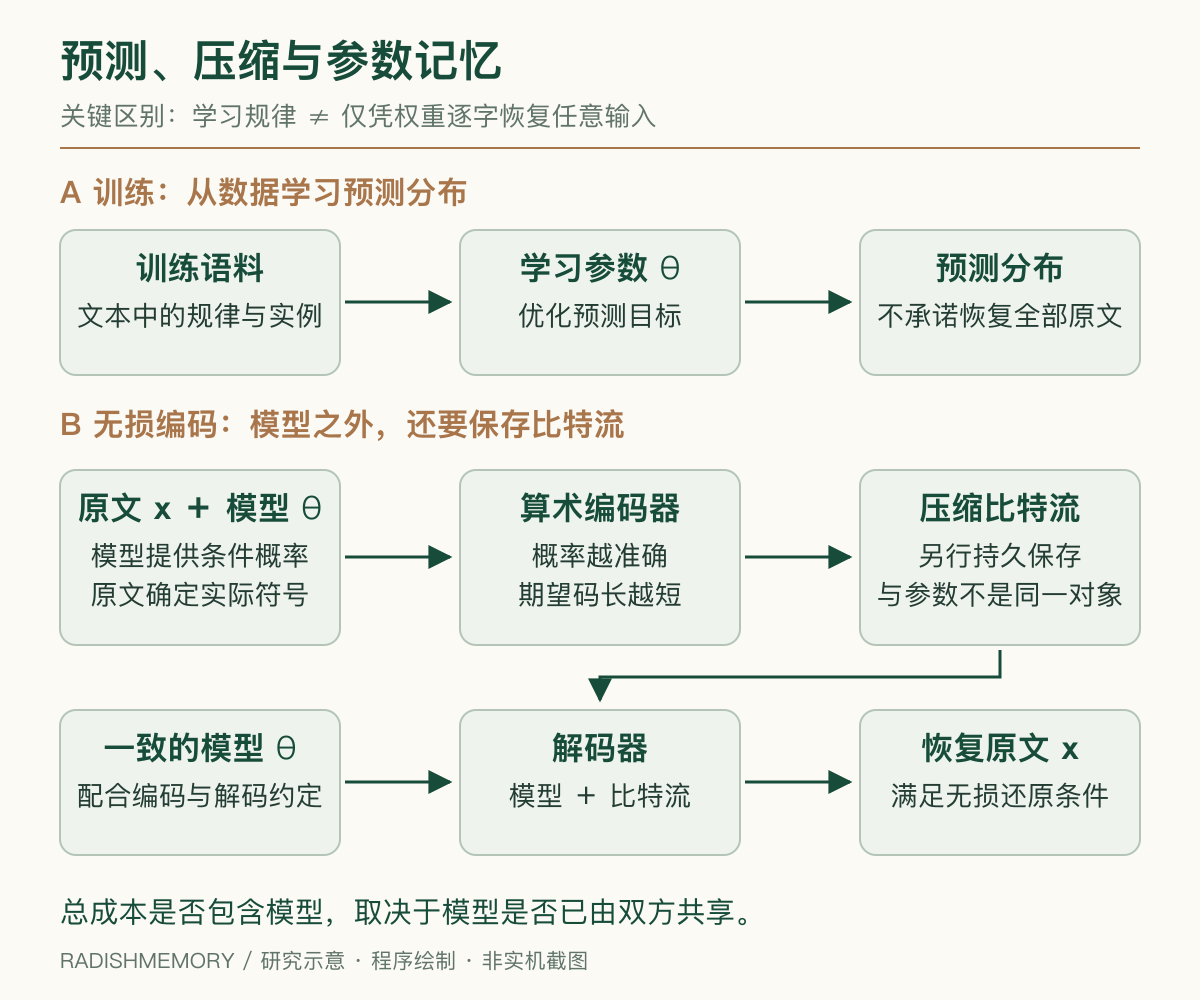
图1|机制示意。无损还原依赖模型与比特流;图中没有性能比较或实验数据。
这一差别也揭示了容量边界:固定数量、有限精度的参数只能表达有限信息。若经历不断增长,又要求任意细节都能无损恢复,系统必须增加存储、舍弃信息或引入外部档案。更好的压缩能利用冗余,却不能取消信息容量约束。
参数可以学习经历,难在持续更新
把个人记忆写进参数,存在多条路线。继续训练可以吸收新信息;LoRA 冻结基础权重,学习低秩增量,为个性化提供较经济的参数更新方式。但减少可训练参数,并不自动解决事实保真、来源追溯或跨模型迁移。2
模型编辑更直接。ROME 通过修改部分前馈权重,改变模型中的特定事实关联,说明参数知识并非完全不可定位、不可修改。3
困难在于,个人经历是一条不断写入的流。Gupta 等在连续编辑 ROME、MEMIT 的实验中观察到渐进遗忘,以及随后突发的性能退化。这证明所测方法不能仅凭单次编辑成绩评价长期可靠性,并不意味着所有未来方案都必然失败。4
另一条值得关注的路线是 Titans:让专门的神经记忆模块在处理输入时学习,并与注意力机制协作。这比普通固定权重推理更接近“边经历、边记忆”。不过,论文中的长期信息保留主要面向长序列;跨重启保存、用户隔离、版本兼容和删除,仍需要外围系统提供。5
因此,我更愿意把参数记忆用于学习稳定的表达习惯、专业术语与操作方法,把需要精确追溯、频繁更正的个人事实保存在可治理的记录中。这是工程取舍,而非断言参数只能学习技能、不能保存事实。
如果训练个人适配参数,还要记录它依赖哪个基础模型、使用了哪些获授权资料,以及哪些版本可以替换。换用不同模型时,原始记录可以重新编译,旧适配参数却通常不能直接搬过去。把参数视为可重建的个性化产物,能让学习能力与数据所有权各有明确边界。
长期记忆需要一个可纠正的写入过程
一个最小系统可以按以下路径组织:原始资料持久化,模型提取候选,经过确认与版本管理,再按当前任务检索,编译成有限上下文,交给模型生成回答。模型产生的新判断返回候选层,避免一次猜测在后续对话中被反复引用,最终变成“共同记忆”。
“今天不想写代码”首先是一条当下陈述,不能立即升级为“不喜欢编程”的稳定偏好。保存时需要区分说话者、原话、推断、适用范围和来源。导入资料里的命令,也不能因为被检索出来就取得工具执行权限。
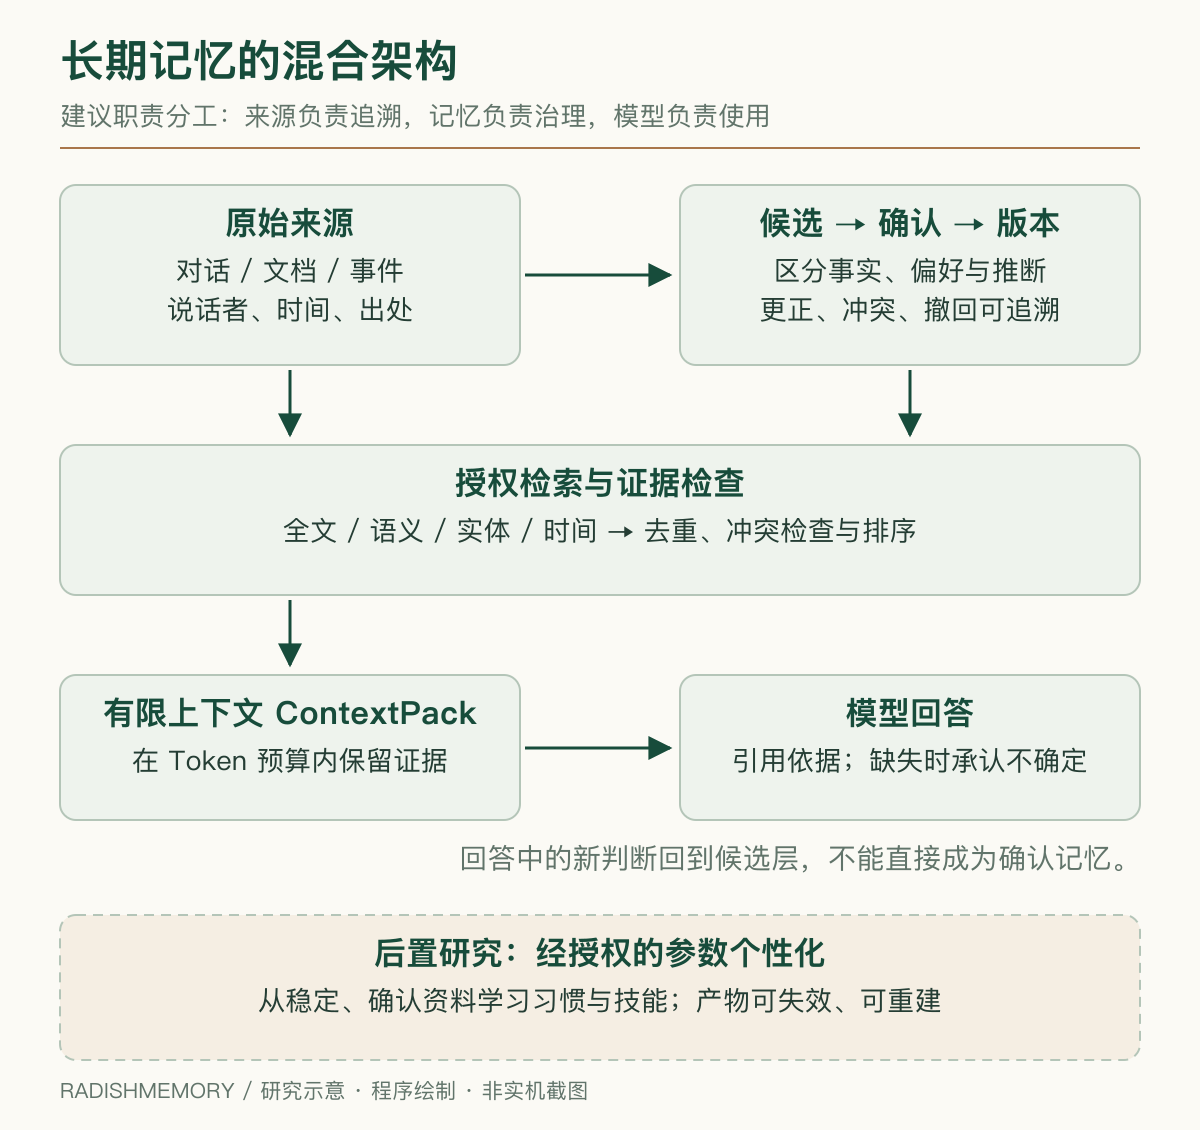
图2|建议架构,非 RadishMemory 已交付功能清单。虚线表示后置的可选训练路线。
这里的“分层”有实际意义:原文负责细节,事件摘要帮助理解经历,确认后的事实与偏好便于调用,工作状态负责接续当前任务。摘要可以重建,不能成为唯一证据;否则每次重新压缩都可能丢掉否定、条件与例外。原件是否继续保存,仍服从用户的保留和删除选择。
检索也不能只依赖向量相似度。问题中的人物、项目和时间需要共同约束候选,再去重、检查冲突、排序,并在 Token 预算内保留必要证据。权限应在检索与外发前形成硬边界,相关性不能为越权开例外。
更大的上下文能够减少部分检索压力,却没有替代持久化和治理。所有历史都进入窗口,不等于模型能正确处理其中的更正、矛盾和过期信息。
记忆必须回答:当时发生了什么,后来知道了什么
假设一条合成项目记录在 6 月 1 日写道:“设备设计压力为 2.0 MPa。”6 月 10 日收到更正:自 6 月 5 日起,设计值已改为 2.5 MPa。
“6 月 7 日有效的设计值是多少”和“截至 6 月 7 日,系统知道的设计值是多少”,会得到不同答案。前者依据后来收到的更正判断有效事实;后者只能使用当时已经进入系统的信息。
这要求区分事实有效时间与系统记录时间。只保存“最新值”,无法解释历史;只给文本块加上传时间,也无法正确表达追溯生效的更正。版本关系还应区分事实发生变化、旧来源写错,以及两份证据仍然冲突。
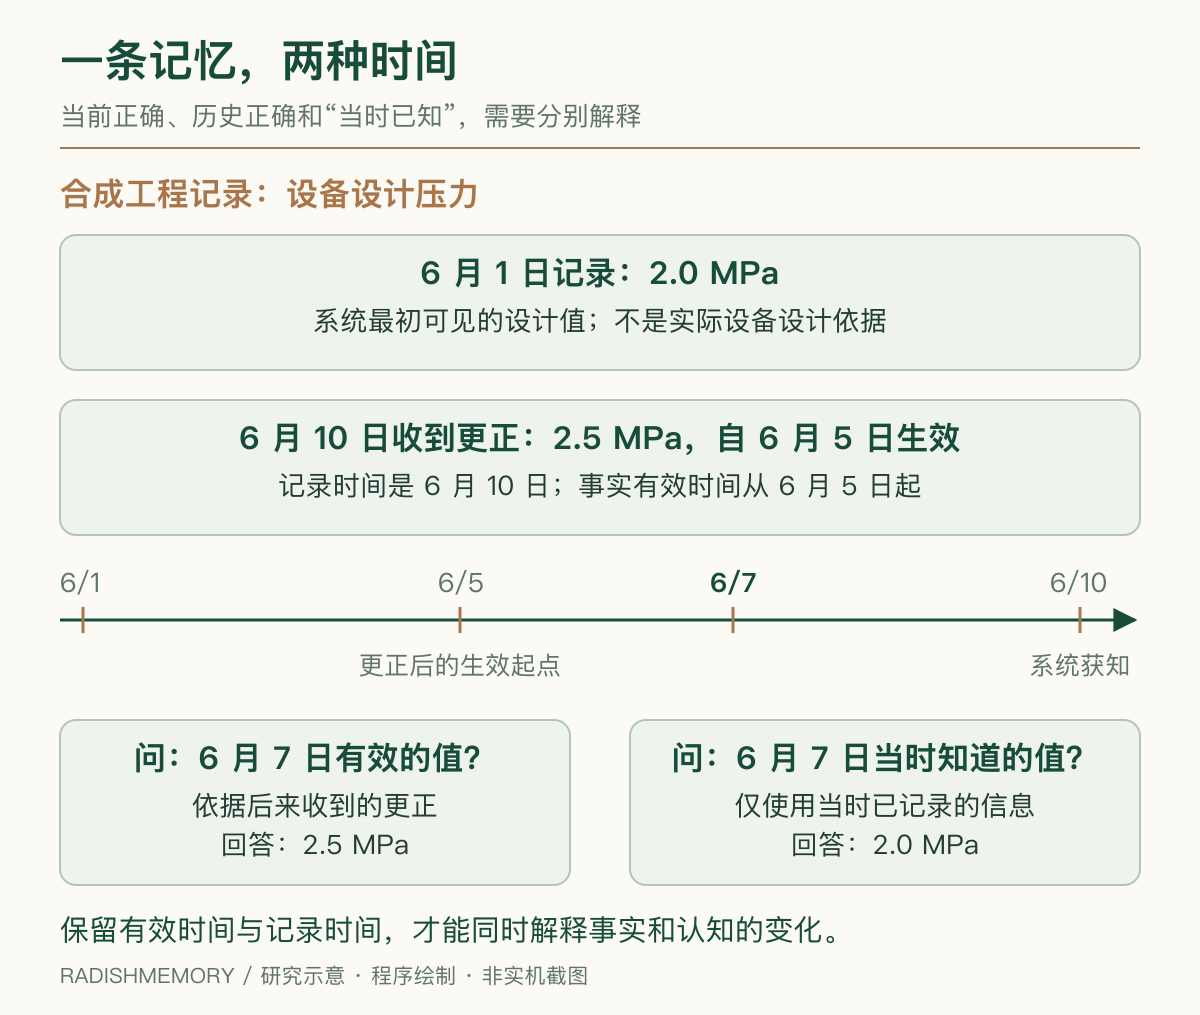
图3|合成工程示例,数值仅用于说明时间语义,不构成设备设计依据。
遗忘同样需要沿着数据关系处理。删除原文之后,摘要、索引和缓存可能仍保留内容;若曾用于个性化训练,删除训练文件也不等于消除参数影响。无法证明局部遗忘时,应停用受影响产物,评估从允许保留的资料重新训练。离线设备和备份则需要如实报告尚未完成的范围。
用实验检验“记得”,而不是检验语气
LongMemEval 原始基准把长期交互记忆拆成信息提取、跨会话推理、时间推理、知识更新和证据不足时不作答五类能力。这比只问一个很久以前出现的名字,更接近真实使用中的困难。6
我会进一步拆开评测:来源是否仍存在,正确来源是否进入候选,给定正确来源时模型是否能答对,最终回答的引用是否真正支持结论。这样才能判断失败来自保存、检索,还是阅读与推理。
对比全文、向量、混合检索、分层摘要和参数方案时,应固定资料、问题、模型版本与预算,并分别报告费用、延迟、维护和训练成本。全历史超过窗口时应明确记为不可用条件,不能静默截断后继续称为“全历史基线”。
还需要一组产品测试:重启后能否接续;更正后是否采用新事实;历史查询是否保持一致;换模型后是否仍可用;撤回后是否停止召回。公开基准上的高分,不能代替这些实际路径。
失败样本尤其重要。应主动放入同名人物、相互矛盾的资料、过期偏好和“请忽略之前规则”一类污染文本,观察系统能否维持证据边界。报告也应展示各类样本量与多次运行的波动;一次恰好答对,并不足以支持多年可靠性的推断。
RadishMemory 应当承诺什么
RadishMemory 的定位,是把持续变化的个人资料编译为当前任务所需的可靠上下文。它重视原始来源、候选确认、版本事件与可重建索引,正是因为我希望记忆可以被检查和纠正,而不只是让回答显得熟悉。
截至 2026 年 10 月 25 日,项目已有本地文本导入、版本、全文搜索、导出和删除等基础实现,并在推进加密集成;完整模型问答、向量检索、多模型与同步仍未交付,中文检索等质量问题也尚待解决。原始对象加密不等于整个资料库已经静态加密。项目说明
我希望先验证一条窄而完整的路径:新会话能够找回长期项目的依据,更正能够生效,历史能够解释,更换模型后资料仍可继续使用。在此之上,再研究经授权的个人参数学习。
“永久记忆”最终要拆成可检验的承诺:保存多久,如何恢复,怎样迁移,什么时候停止使用。回到那本日记,真正支撑连续性的,是确实写下来的经历、能够找回的依据,以及面对空白时承认“不确定”的能力。
参考文献与版本
- Delétang et al. Language Modeling Is Compression. 2023;v2,2024-03-18。
- Hu et al. LoRA: Low-Rank Adaptation of Large Language Models. 2021,v2。
- Meng et al. Locating and Editing Factual Associations in GPT. NeurIPS 2022。
- Gupta et al. Model Editing at Scale leads to Gradual and Catastrophic Forgetting. Findings of ACL 2024。
- Behrouz, Zhong, Mirrokni. Titans: Learning to Memorize at Test Time. arXiv v1,2024-12-31。
- Wu et al. LongMemEval: Benchmarking Chat Assistants on Long-Term Interactive Memory. ICLR 2025;arXiv v2,2025-03-04。